
spark on yarn集群
Spark on YARN 集群部署(Hadoop HA + ZooKeeper + Spark)
集群版本:Hadoop 3.3.6、ZooKeeper 3.8.4、Spark 3.5.6(
spark-3.5.6-bin-hadoop3)、JDK 8。
集群规模:node01 ~ node03 共 3 个节点,HDFS 双 NameNode(nn1/nn2)、YARN 双 ResourceManager(rm1/rm2),ZooKeeper 3 节点提供主备选举。
部署用户:root负责安装与系统配置,hadoop负责集群启停与作业提交。
1. 集群规划
1.1 节点角色规划
| 节点 | IP(示例) | 角色 | 说明 |
|---|---|---|---|
| node01 | 192.168.1.11 | NameNode(nn1)、ZKFC、JournalNode、DataNode、NodeManager、ZooKeeper、Spark History Server | HDFS 主/备由 ZKFC 选举;Spark 历史服务器固定在此节点 |
| node02 | 192.168.1.12 | NameNode(nn2)、ZKFC、JournalNode、DataNode、NodeManager、ZooKeeper、ResourceManager(rm1) | YARN 主/备由 ZooKeeper 选举 |
| node03 | 192.168.1.13 | JournalNode、DataNode、NodeManager、ZooKeeper、ResourceManager(rm2)、JobHistoryServer | 无 NameNode/ZKFC |
1.2 软件版本
| 组件 | 版本 | 安装目录 | 软链接 |
|---|---|---|---|
| JDK | 1.8 | /opt/jdk1.8.0_361 | /opt/jdk |
| ZooKeeper | 3.8.4 | /opt/apache-zookeeper-3.8.4-bin | /opt/zookeeper |
| Hadoop | 3.3.6 | /opt/hadoop-3.3.6 | /opt/hadoop |
| Spark | 3.5.6 | /opt/spark-3.5.6-bin-hadoop3 | /opt/spark |
1.3 主机名与 IP 映射
# 三个节点均需配置(/etc/hosts),IP 以实际环境为准
192.168.1.11 node01
192.168.1.12 node02
192.168.1.13 node03
1.4 端口规划
除注明外均为自定义端口(在 Hadoop 默认端口基础上整体 +10000,便于与其它服务隔离)。
| 组件 | 端口 | 用途 |
|---|---|---|
| ZooKeeper | 2181 / 2888 / 3888 | 客户端 / Leader-Follower 数据同步 / 选举 |
| ZooKeeper | 8080 | AdminServer(3.5+ 默认开启,如被占用可设 admin.serverPort) |
| HDFS | 8020 | NameNode RPC(dfs.namenode.rpc-address) |
| HDFS | 9870 | NameNode Web UI |
| HDFS | 8485 | JournalNode |
| HDFS | 9866/9864 | DataNode 数据传输 / DataNode Web UI |
| YARN | 8088 | ResourceManager Web UI |
| YARN | 8030/8031/8032/8033 | Scheduler / Resource-Tracker / RM 内部通信 / RM Admin |
| YARN | 8040 | NodeManager Localizer |
| YARN | 8042 | NodeManager Web UI |
| MapReduce | 10020 / 19888 | JobHistoryServer RPC / Web UI |
| Spark | 18080 | Spark History Server Web UI |
| Spark | 7337 | Spark Shuffle Service(spark.shuffle.service.port) |
| 系统 | 22 | SSH(HA 隔离 sshfence 依赖) |
若生产环境不允许关闭防火墙,需放行上表端口(含
8042),并保证hdfs/yarn的 Web UI 端口在客户端可达。
1.5 目录规划
| 目录 | 用途 |
|---|---|
/data/hadoop/tmp | hadoop.tmp.dir |
/data/hadoop/nn、/data/hadoop/dn、/data/hadoop/jn | NameNode / DataNode / JournalNode 数据 |
/data/hadoop/zookeeper/data、.../logs/txlog | ZooKeeper 数据与事务日志(含 myid) |
/data/hadoop/logs/{nn,dn,jn,rm,nm,proxyserver,jobhistory} | 各守护进程日志目录 |
/data/hadoop/logs/yarn/container-logs | YARN 容器日志 |
/data/hadoop/yarn/local | NodeManager 本地工作目录 |
/data/hadoop/pid | 各守护进程 PID 文件 |
/data/hadoop/spark/{pid,work,logs/history-server} | Spark PID、临时目录、History Server 日志 |
HDFS /jobhistory/done、/jobhistory/done_intermediate | MapReduce 作业历史(mapred-site.xml) |
HDFS /spark-jars、/sparkhistory | Spark 依赖归档、Spark 事件日志 |
2. 基础环境配置
以下除特别说明外,均在 node01、node02、node03 三个节点执行(以 root 身份)。
2.1 前置准备
# 1) 确认操作系统与主机名解析(CentOS 7.x/Rocky/openEuler/kylin 均可)
cat /etc/os-release

# 2) 安装常用依赖(zip 用于打包 Spark 依赖,后续 3.6.10 必需)
yum install -y psmisc nc zip unzip bzip2 wget lsof

# 3) 将安装包上传到各节点(示例路径)
mkdir -p /opt/soft
# jdk-8u361-linux-x64.tar.gz
# apache-zookeeper-3.8.4-bin.tar.gz
# hadoop-3.3.6.tar.gz
# spark-3.5.6-bin-hadoop3.tgz
2.2 关闭防火墙
systemctl stop firewalld
systemctl disable firewalld

# 验证:应显示 inactive (dead)
systemctl status firewalld
生产环境建议改为按 1.4 端口规划 放行端口,而不是直接关闭防火墙。
2.3 关闭 SELinux
# 临时关闭
setenforce 0
# 永久关闭
sed -i 's/^SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/config

# 验证:getenforce 应输出 Permissive
getenforce
grep '^SELINUX=' /etc/selinux/config
2.4 关闭 swap
# 临时关闭
swapoff -a
# 永久关闭(注释 /etc/fstab 中挂载点为 swap 的行,并保留备份)
sed -i.bak '/[[:space:]]swap[[:space:]]/ s/^/#/' /etc/fstab

# 验证:Swap 行应为 0,swapon --show 应无输出
free -h
swapon --show
2.5 修改主机名
按节点分别执行:
# node01 执行
hostnamectl set-hostname node01

# node02 执行
hostnamectl set-hostname node02

# node03 执行
hostnamectl set-hostname node03

# 各节点验证
hostname
执行后当前会话提示符不会立即变化,
exit重新登录或执行exec bash即可。
2.6 添加主机名映射
# 三个节点均执行('EOF' 加引号可避免变量被提前展开)
cat >> /etc/hosts <<'EOF'
192.168.1.11 node01
192.168.1.12 node02
192.168.1.13 node03
EOF

# 验证
getent hosts node01
ping -c 2 node02
若从 Windows 客户端访问 Web UI,需在客户端的
C:\Windows\System32\drivers\etc\hosts中加入同样的映射,否则http://node01:9870无法解析。
2.7 配置时间同步
集群各组件(ZooKeeper 选举、HDFS HA、YARN HA、Kerberos)对时间一致性敏感,必须保证三节点时间同步。
node01(时间服务器)
vim /etc/chrony.conf

# 1) 如果无法访问互联网,注释掉默认的互联网时间源,避免与本地时间源冲突
# pool 2.centos.pool.ntp.org iburst

# 2) 允许内网客户端同步(按实际网段修改)
allow 192.168.1.0/24

# 3) 即使 node01 未同步到外部时间源,也以 stratum 10 对外提供时间
local stratum 10
node02、node03(客户端)
vim /etc/chrony.conf

# 注释掉默认的互联网时间源,改为以 node01 为基准
# pool 2.centos.pool.ntp.org iburst
server node01 iburst
所有节点
systemctl restart chronyd
systemctl enable chronyd

# 验证
timedatectl status     # 关注 System clock synchronized: yes、NTP service: active
chronyc sources -v     # node02/node03 的 ^* 行应指向 node01
chronyc tracking
说明:
timedatectl status只是查看状态;若显示NTP service: inactive,执行timedatectl set-ntp true后再重启chronyd(系统装有 chrony 时该命令实际就是启用chronyd)。- 必须注释掉
pool 2.centos.pool.ntp.org iburst,否则 node01 会优先与互联网同步,local stratum 10形同虚设,内网节点也可能各连各的外部源。
2.8 创建用户并配置免密
2.8.1 创建用户和用户组
三个节点(node01、node02、node03)均执行:
# 创建用户组
groupadd hadoop
# 创建 hadoop 用户
useradd -g hadoop -s /bin/bash -m -d /home/hadoop hadoop
# 设置用户密码
passwd hadoop
2.8.2 配置免密登录
Hadoop 的一键脚本(start-dfs.sh/start-yarn.sh)以及 HDFS HA 的 sshfence 隔离机制都依赖 SSH 免密,root 与 hadoop 两个用户都必须配置。
root 用户(三个节点执行)
su - root
# 生成密钥
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
# 分发公钥到所有节点(含自身)
ssh-copy-id root@node01
ssh-copy-id root@node02
ssh-copy-id root@node03

# 验证
ssh root@node02 hostname
hadoop 用户(三个节点执行)
su - hadoop
# 生成密钥
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
# 分发公钥到所有节点(含自身)
ssh-copy-id hadoop@node01
ssh-copy-id hadoop@node02
ssh-copy-id hadoop@node03

# 验证(应无密码直接返回主机名)
ssh hadoop@node02 hostname
ssh hadoop@node03 hostname
注意事项:
- 必须包含自身(
ssh-copy-id到本机),否则start-dfs.sh、sshfence会失败。- 建议使用 RSA 密钥(而非 ed25519):
sshfence由 Java 侧的 SSH 客户端实现,部分版本的 JDK 8 不支持 ed25519。- 可选的加固:
chmod 700 ~/.ssh && chmod 600 ~/.ssh/authorized_keys。- 后续所有操作请使用
su - hadoop(带-,登录式 shell),否则读不到/etc/profile.d中的环境变量。
2.9 系统参数优化(可选)
# 关闭透明大页,减少 JVM 长停顿(重启后失效,可写入 /etc/rc.d/rc.local 或用 tuned 持久化)
echo never > /sys/kernel/mm/transparent_hugepage/enabled

# 提高文件句柄数与进程数上限
cat >> /etc/security/limits.conf <<'EOF'
* soft nofile 65536
* hard nofile 65536
* soft nproc  65536
* hard nproc  65536
EOF

# 降低内核 swap 倾向(已关闭 swap 时可跳过)
sysctl -w vm.swappiness=0
3. 部署 Hadoop HA + Spark on YARN 集群
3.1 安装 Java 8
三个节点均执行:
su - root
# 解压安装包
tar zxf jdk-8u361-linux-x64.tar.gz -C /opt/
# 建立统一软链接:后续所有配置统一使用 /opt/jdk
ln -s /opt/jdk1.8.0_361 /opt/jdk

# 验证
/opt/jdk/bin/java -version    # 应显示 1.8.0_361
3.2 安装 ZooKeeper 3.8.4
三个节点均执行:
su - root
# 解压安装包
tar zxf apache-zookeeper-3.8.4-bin.tar.gz -C /opt/
# 创建软链接(使用绝对路径,避免依赖当前目录)
ln -s /opt/apache-zookeeper-3.8.4-bin /opt/zookeeper

# 复制配置文件
cd /opt/zookeeper/conf
cp zoo_sample.cfg zoo.cfg
编辑 /opt/zookeeper/conf/zoo.cfg,核心内容如下(zoo_sample.cfg 中的默认值可直接覆盖):
# 基本参数
tickTime=2000
initLimit=10
syncLimit=5
clientPort=2181

# 数据目录与事务日志目录(务必分开,避免事务日志与快照互相影响)
dataDir=/data/hadoop/zookeeper/data
dataLogDir=/data/hadoop/zookeeper/logs/txlog

# 自动清理快照与事务日志(单位:小时)
autopurge.snapRetainCount=5
autopurge.purgeInterval=24

# 集群成员:server.<myid>=<host>:<数据同步端口>:<选举端口>
server.1=node01:2888:3888
server.2=node02:2888:3888
server.3=node03:2888:3888

# AdminServer(ZK 3.5+ 默认开启,端口 8080;如被占用请改为其它端口)
admin.enableServer=true
admin.serverPort=8080
修改日志目录(注意是 conf/logback.xml,原文档只写了 logback.xml,容易找不到文件):
vim /opt/zookeeper/conf/logback.xml
# 默认日志目录为 zookeeper 安装目录下的 logs,改为:
# <property name="zookeeper.log.dir" value="/data/hadoop/zookeeper/logs" />
创建数据目录并写入 myid(myid 与 zoo.cfg 中的 server.N 必须一一对应,每台机器只写自己的编号):
mkdir -p /data/hadoop/zookeeper/data
mkdir -p /data/hadoop/zookeeper/logs/txlog

# node01 执行
echo 1 > /data/hadoop/zookeeper/data/myid
# node02 执行
echo 2 > /data/hadoop/zookeeper/data/myid
# node03 执行
echo 3 > /data/hadoop/zookeeper/data/myid

# 修改目录所属(三节点)
chown -R hadoop:hadoop /data/hadoop/zookeeper
chown -R hadoop:hadoop /opt/apache-zookeeper-3.8.4-bin
3.3 安装 Hadoop 3.3.6
三个节点均执行:
su - root
# 解压安装包
tar zxf hadoop-3.3.6.tar.gz -C /opt/
# 创建软链接
ln -s /opt/hadoop-3.3.6 /opt/hadoop
以下配置文件均位于 /opt/hadoop/etc/hadoop/,可保留文件头部的 license 注释,只替换 <configuration> 内容。
3.3.1 修改 core-site.xml
<configuration>
    <!-- 指定 HDFS 的逻辑集群名称(HA nameservice)。
         不写端口时默认使用 8020,与 dfs.namenode.rpc-address 中配置的端口一致 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop-ha</value>
    </property>
    <!-- 指定 Hadoop 运行时产生文件的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/data/hadoop/tmp</value>
    </property>
    <!-- 指定 zkfc 要连接的 zkServer 地址 -->
    <property>
        <name>ha.zookeeper.quorum</name>
        <value>node01:2181,node02:2181,node03:2181</value>
    </property>
    <!-- 指定 Web 页面使用的用户 -->
    <property>
        <name>hadoop.http.staticuser.user</name>
        <value>hadoop</value>
    </property>
    <!-- 允许跨域访问(部分代理/监控组件需要) -->
    <property>
        <name>hadoop.http.cross-origin.enabled</name>
        <value>true</value>
    </property>
</configuration>
3.3.2 修改 hdfs-site.xml
<configuration>
    <!-- 集群名称(与 fs.defaultFS 中的 nameservice 一致) -->
    <property>
        <name>dfs.nameservices</name>
        <value>hadoop-ha</value>
    </property>
    <!-- 集群中 NameNode 节点都有哪些 -->
    <property>
        <name>dfs.ha.namenodes.hadoop-ha</name>
        <value>nn1,nn2</value>
    </property>
    <!-- NameNode 的 RPC 通信地址 -->
    <property>
        <name>dfs.namenode.rpc-address.hadoop-ha.nn1</name>
        <value>node01:8020</value>
    </property>
    <property>
        <name>dfs.namenode.rpc-address.hadoop-ha.nn2</name>
        <value>node02:8020</value>
    </property>
    <!-- NameNode 的 http 通信地址 -->
    <property>
        <name>dfs.namenode.http-address.hadoop-ha.nn1</name>
        <value>node01:9870</value>
    </property>
    <property>
        <name>dfs.namenode.http-address.hadoop-ha.nn2</name>
        <value>node02:9870</value>
    </property>
    <!-- JournalNode 共享编辑日志地址 -->
    <property>
        <name>dfs.namenode.shared.edits.dir</name>
        <value>qjournal://node01:8485;node02:8485;node03:8485/hadoop-ha</value>
    </property>
    <!-- 客户端故障转移代理 -->
    <property>
        <name>dfs.client.failover.proxy.provider.hadoop-ha</name>
        <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>
    <!-- 故障转移隔离方法:同一时刻只允许一台 NameNode 对外服务。 -->
    <property>
        <name>dfs.ha.fencing.methods</name>
        <value>sshfence</value>
    </property>
    <!-- 使用隔离机制时需要 ssh 密钥登录(对应 2.8.2 中 hadoop 用户的密钥) -->
    <property>
        <name>dfs.ha.fencing.ssh.private-key-files</name>
        <value>/home/hadoop/.ssh/id_rsa</value>
    </property>
    <!-- 启用 nn 故障自动转移 -->
    <property>
        <name>dfs.ha.automatic-failover.enabled</name>
        <value>true</value>
    </property>
    <!-- 指定 HDFS 副本数量(3 个 DataNode 时建议设为 3) -->
    <property>
        <name>dfs.replication</name>
        <value>3</value>
    </property>
    <!-- NameNode 数据存储目录 -->
    <property>
        <name>dfs.namenode.name.dir</name>
        <value>/data/hadoop/nn</value>
    </property>
    <!-- DataNode 数据存储目录 -->
    <property>
        <name>dfs.datanode.data.dir</name>
        <value>/data/hadoop/dn</value>
    </property>
    <!-- JournalNode 日志存储目录 -->
    <property>
        <name>dfs.journalnode.edits.dir</name>
        <value>/data/hadoop/jn</value>
    </property>
    <!-- 块大小(128MB) -->
    <property>
        <name>dfs.blocksize</name>
        <value>134217728</value>
    </property>
    <!-- 开启 Web UI(Hadoop 3 默认已开启,可保留也可省略) -->
    <property>
        <name>dfs.webhdfs.enabled</name>
        <value>true</value>
    </property>

    <!-- ============================================================
         可选:当 /etc/hosts 或 DNS 不完善、出现 DataNode 注册失败
         (日志报 Problem connecting to server / 反向解析失败)时启用
    <property>
        <name>dfs.namenode.datanode.registration.ip-hostname-check</name>
        <value>false</value>
    </property>
    <property>
        <name>dfs.datanode.use.datanode.hostname</name>
        <value>true</value>
    </property>
         ============================================================ -->
</configuration>
3.3.3 修改 mapred-site.xml
<configuration>
    <!-- 指定 MapReduce 程序运行在 Yarn 上 -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
    <!-- 历史服务器端地址 -->
    <property>
        <name>mapreduce.jobhistory.address</name>
        <value>node03:10020</value>
    </property>
    <!-- 历史服务器 web 端地址 -->
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>node03:19888</value>
    </property>
    <!-- 已完成作业的日志存放目录(HDFS,相对路径基于 fs.defaultFS 解析) -->
    <property>
        <name>mapreduce.jobhistory.done-dir</name>
        <value>/jobhistory/done</value>
        <description>已完成作业的日志永久存储路径</description>
    </property>
    <!-- 运行中作业的临时日志目录(HDFS),权限必须为 1777 -->
    <property>
        <name>mapreduce.jobhistory.intermediate-done-dir</name>
        <value>/jobhistory/done_intermediate</value>
        <description>作业运行期间的临时日志路径,完成后迁移到 done-dir</description>
    </property>
    <!-- 日志清理策略 -->
    <property>
        <name>mapreduce.jobhistory.cleaner.enable</name>
        <value>true</value>
    </property>
    <property>
        <name>mapreduce.jobhistory.cleaner.interval-ms</name>
        <value>86400000</value>
        <description>清理线程运行间隔,单位毫秒(默认 1 天)</description>
    </property>
    <property>
        <name>mapreduce.jobhistory.max-age-ms</name>
        <value>1209600000</value>
        <description>作业历史记录保留时间,单位毫秒(14 天)</description>
    </property>
</configuration>
3.3.4 修改 yarn-site.xml
<configuration>
    <!-- ========== ResourceManager HA ========== -->
    <property>
        <name>yarn.resourcemanager.ha.enabled</name>
        <value>true</value>
    </property>
    <!-- 集群标识(ZK 中状态存储的命名空间) -->
    <property>
        <name>yarn.resourcemanager.cluster-id</name>
        <value>yarn-cluster</value>
    </property>
    <!-- 指定 ResourceManager 的逻辑列表 -->
    <property>
        <name>yarn.resourcemanager.ha.rm-ids</name>
        <value>rm1,rm2</value>
    </property>
    <!-- 启用自动故障转移(HA 开启时默认即为 true,建议显式声明) -->
    <property>
        <name>yarn.resourcemanager.ha.automatic-failover.enabled</name>
        <value>true</value>
    </property>

    <!-- ========== rm1(node02) ========== -->
    <property>
        <name>yarn.resourcemanager.hostname.rm1</name>
        <value>node02</value>
    </property>
    <property>
        <name>yarn.resourcemanager.webapp.address.rm1</name>
        <value>node02:8088</value>
    </property>
    <property>
        <name>yarn.resourcemanager.scheduler.address.rm1</name>
        <value>node02:8030</value>
    </property>
    <property>
        <name>yarn.resourcemanager.resource-tracker.address.rm1</name>
        <value>node02:8031</value>
    </property>
    <property>
        <name>yarn.resourcemanager.address.rm1</name>
        <value>node02:8032</value>
    </property>
    <property>
        <name>yarn.resourcemanager.admin.address.rm1</name>
        <value>node02:8033</value>
    </property>

    <!-- ========== rm2(node03) ========== -->
    <property>
        <name>yarn.resourcemanager.hostname.rm2</name>
        <value>node03</value>
    </property>
    <property>
        <name>yarn.resourcemanager.webapp.address.rm2</name>
        <value>node03:8088</value>
    </property>
    <property>
        <name>yarn.resourcemanager.scheduler.address.rm2</name>
        <value>node03:8030</value>
    </property>
    <property>
        <name>yarn.resourcemanager.resource-tracker.address.rm2</name>
        <value>node03:8031</value>
    </property>
    <property>
        <name>yarn.resourcemanager.address.rm2</name>
        <value>node03:8032</value>
    </property>
    <property>
        <name>yarn.resourcemanager.admin.address.rm2</name>
        <value>node03:8033</value>
    </property>

    <!-- 容器本地化服务端口 -->
    <property>
        <name>yarn.nodemanager.localizer.address</name>
        <value>0.0.0.0:8040</value>
    </property>

    <!-- ========== ZooKeeper 与状态恢复 ========== -->
    <property>
        <name>yarn.resourcemanager.zk-address</name>
        <value>node01:2181,node02:2181,node03:2181</value>
    </property>
    <property>
        <name>yarn.resourcemanager.recovery.enabled</name>
        <value>true</value>
    </property>
    <property>
        <name>yarn.resourcemanager.store.class</name>
        <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
    </property>

    <!-- 环境变量的继承 -->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>

    <!-- ========== NodeManager 辅助服务:MapReduce + Spark Shuffle ========== -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle,spark_shuffle</value>
    </property>
    <property>
        <name>yarn.nodemanager.aux-services.spark_shuffle.class</name>
        <value>org.apache.spark.network.yarn.YarnShuffleService</value>
    </property>

    <!-- ========== 资源限制 ========== -->
    <!-- NodeManager 可用于运行容器的总内存(MB),不得超过物理内存 -->
    <property>
        <name>yarn.nodemanager.resource.memory-mb</name>
        <value>102400</value>
    </property>
    <!-- NodeManager 可用于运行容器的总 vcores 数 -->
    <property>
        <name>yarn.nodemanager.resource.cpu-vcores</name>
        <value>30</value>
    </property>
    <!-- 每个容器允许的最小/最大内存(MB) -->
    <property>
        <name>yarn.scheduler.minimum-allocation-mb</name>
        <value>512</value>
    </property>
    <property>
        <name>yarn.scheduler.maximum-allocation-mb</name>
        <value>10240</value>
    </property>
    <!-- 每个容器允许的最小/最大 vcores -->
    <property>
        <name>yarn.scheduler.minimum-allocation-vcores</name>
        <value>1</value>
    </property>
    <property>
        <name>yarn.scheduler.maximum-allocation-vcores</name>
        <value>5</value>
    </property>
    <!-- 物理内存检查:超出分配值即杀掉容器(建议保留 true) -->
    <property>
        <name>yarn.nodemanager.pmem-check-enabled</name>
        <value>true</value>
    </property>
    <!-- 虚拟内存检查:建议关闭。
         JVM 申请的虚拟内存远大于实际使用量,开启后 Spark 容器常被误杀,
         日志中会出现 "Container ... is running beyond virtual memory limits" -->
    <property>
        <name>yarn.nodemanager.vmem-check-enabled</name>
        <value>false</value>
    </property>

    <!-- ========== NodeManager 本地工作目录 ========== -->
    <property>
        <name>yarn.nodemanager.local-dirs</name>
        <value>/data/hadoop/yarn/local</value>
    </property>
    <!-- ========== Container 日志目录 ========== -->
    <property>
        <name>yarn.nodemanager.log-dirs</name>
        <value>/data/hadoop/logs/yarn/container-logs</value>
    </property>
    <!-- 作业完成后临时文件清理延迟(0 = 立即清理;排障时可临时调大) -->
    <property>
        <name>yarn.nodemanager.delete.debug-delay-sec</name>
        <value>0</value>
    </property>

    <!-- ========== 日志聚集 ========== -->
    <property>
        <name>yarn.log-aggregation-enable</name>
        <value>true</value>
    </property>
    <!-- 日志聚集服务器地址(JobHistoryServer) -->
    <property>
        <name>yarn.log.server.url</name>
        <value>http://node03:19888/jobhistory/logs</value>
    </property>
    <!-- 日志保留时间:14 天(1209600 秒;-1 表示永久保留) -->
    <property>
        <name>yarn.log-aggregation.retain-seconds</name>
        <value>1209600</value>
    </property>
    <!-- 日志聚合检查间隔(秒) -->
    <property>
        <name>yarn.log-aggregation.retain-check-interval-seconds</name>
        <value>3600</value>
    </property>
</configuration>
3.3.5 修改 workers
编辑 /opt/hadoop/etc/hadoop/workers(Hadoop 3 中已由 slaves 更名为 workers):
node01
node02
node03
workers决定start-dfs.sh/start-yarn.sh在哪些节点启动 DataNode 与 NodeManager;NameNode、JournalNode、ZKFC 的位置由hdfs-site.xml推导,不依赖该文件。
3.3.6 修改 hadoop-env.sh
编辑 /opt/hadoop/etc/hadoop/hadoop-env.sh,在文件末尾追加以下内容:
export JAVA_HOME=/opt/jdk
export HADOOP_HOME=/opt/hadoop
export HADOOP_HEAPSIZE_MAX=8192

# 统一日志根目录(默认为 $HADOOP_HOME/logs)
export HADOOP_LOG_DIR=/data/hadoop/logs
# 统一 PID 文件目录
export HADOOP_PID_DIR=/data/hadoop/pid

# 各守护进程堆内存与日志目录。
# 注意:值末尾追加 $XXX_OPTS,用于保留 hadoop-env.sh 原有的安全/审计日志配置
export HDFS_NAMENODE_OPTS="-Xmx8g -Xms8g -XX:+UseG1GC -XX:MaxGCPauseMillis=400 -Dhadoop.log.dir=${HADOOP_LOG_DIR}/nn -Xloggc:${HADOOP_LOG_DIR}/nn/gc.log -XX:+PrintGCDetails -XX:+PrintGCDateStamps -XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=5 -XX:GCLogFileSize=10M $HDFS_NAMENODE_OPTS"
export HDFS_DATANODE_OPTS="-Xmx8g -Xms8g -XX:+UseG1GC -XX:MaxGCPauseMillis=400 -Dhadoop.log.dir=${HADOOP_LOG_DIR}/dn -Xloggc:${HADOOP_LOG_DIR}/dn/gc.log -XX:+PrintGCDetails -XX:+PrintGCDateStamps -XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=5 -XX:GCLogFileSize=10M $HDFS_DATANODE_OPTS"
export HDFS_JOURNALNODE_OPTS="-Xmx2g -Xms1g -XX:+UseG1GC -XX:MaxGCPauseMillis=400 -Dhadoop.log.dir=${HADOOP_LOG_DIR}/jn -Xloggc:${HADOOP_LOG_DIR}/jn/gc.log -XX:+PrintGCDetails -XX:+PrintGCDateStamps -XX:+UseGCLogFileRotation -XX:NumberOfGCLogFiles=5 -XX:GCLogFileSize=10M $HDFS_JOURNALNODE_OPTS"
export HDFS_ZKFC_OPTS="-Xmx1g -Xms1g -XX:+UseG1GC -XX:MaxGCPauseMillis=400 -Dhadoop.log.dir=${HADOOP_LOG_DIR}/zkfc $HDFS_ZKFC_OPTS"
export YARN_RESOURCEMANAGER_OPTS="-Dhadoop.log.dir=${HADOOP_LOG_DIR}/rm $YARN_RESOURCEMANAGER_OPTS"
export YARN_NODEMANAGER_OPTS="-Dhadoop.log.dir=${HADOOP_LOG_DIR}/nm $YARN_NODEMANAGER_OPTS"
export YARN_PROXYSERVER_OPTS="-Dhadoop.log.dir=${HADOOP_LOG_DIR}/proxyserver $YARN_PROXYSERVER_OPTS"
export MAPRED_HISTORYSERVER_OPTS="-Dhadoop.log.dir=${HADOOP_LOG_DIR}/jobhistory $MAPRED_HISTORYSERVER_OPTS"

# 客户端/守护进程公共 JVM 参数
export HADOOP_OPTS="-Djava.net.preferIPv4Stack=true $HADOOP_OPTS"
说明:
堆内存必须根据服务器物理内存规格进行配置;HADOOP_HEAPSIZE_MAX仅对没有单独指定-Xmx的守护进程生效。
3.4 安装 Spark 3.5.6
三个节点均执行:
su - root
# 解压安装包
tar -zxvf spark-3.5.6-bin-hadoop3.tgz -C /opt/
# 创建软链接
ln -s /opt/spark-3.5.6-bin-hadoop3 /opt/spark

# 复制配置文件模板
cd /opt/spark/conf
cp spark-env.sh.template spark-env.sh
cp spark-defaults.conf.template spark-defaults.conf
cp log4j2.properties.template log4j2.properties
# workers 仅 Standalone 模式使用,YARN 模式非必需(保留不影响运行)
cp workers.template workers

# 部署 Spark Shuffle Service:三个 NodeManager 节点都必须执行
ls /opt/spark/yarn/spark-*-yarn-shuffle.jar
cp /opt/spark/yarn/spark-3.5.6-yarn-shuffle.jar /opt/hadoop/share/hadoop/yarn/lib/
重要顺序:Shuffle Service 的 jar 必须在启动 NodeManager 之前放到所有 NM 节点的 Hadoop 类路径下,否则
yarn.nodemanager.aux-services=spark_shuffle会因找不到类而导致 NodeManager 启动失败。
另外,spark.shuffle.service.port(7337)必须与spark-defaults.conf中保持一致。
3.4.1 修改 spark-env.sh
编辑 /opt/spark/conf/spark-env.sh:
# Java 安装目录(与 3.1 统一)
export JAVA_HOME=/opt/jdk
# Hadoop 配置目录(YARN 模式的关键配置,spark-submit 据此连接 YARN/HDFS)
export HADOOP_CONF_DIR=/opt/hadoop/etc/hadoop
export YARN_CONF_DIR=/opt/hadoop/etc/hadoop
export HADOOP_HOME=/opt/hadoop

# Spark History Server 自身日志与 PID
export SPARK_LOG_DIR=/data/hadoop/spark/logs/history-server
export SPARK_PID_DIR=/data/hadoop/spark/pid

# History Server 配置(会覆盖 spark-defaults.conf 中的同名项)
export SPARK_HISTORY_OPTS="-Dspark.history.ui.port=18080 \
  -Dspark.history.fs.logDirectory=hdfs://hadoop-ha:8020/sparkhistory \
  -Dspark.history.retainedApplications=50 \
  -Dspark.history.fs.cleaner.enabled=true \
  -Dspark.history.fs.cleaner.interval=12h \
  -Dspark.history.fs.cleaner.maxAge=14d"
3.4.2 修改 spark-defaults.conf
编辑 /opt/spark/conf/spark-defaults.conf:
# ================ 运行模式 ================
spark.master                          yarn
spark.submit.deployMode               cluster

# 使用 HDFS 上预打包的依赖,避免每次提交都上传全部 jar(对应 3.6.10)
spark.yarn.archive                    hdfs://hadoop-ha:8020/spark-jars/spark-libs.zip

# ================ 事件日志 / History Server ================
spark.eventLog.enabled                true
# 应用写入事件日志的目录,必须与 History Server 读取目录一致
spark.eventLog.dir                    hdfs://hadoop-ha:8020/sparkhistory
spark.eventLog.compress               true
spark.history.fs.logDirectory         hdfs://hadoop-ha:8020/sparkhistory
spark.history.fs.cleaner.enabled      true
spark.history.fs.cleaner.interval     12h
spark.history.fs.cleaner.maxAge       14d
spark.history.retainedApplications    50
spark.history.ui.port                 18080
# YARN ResourceManager UI 上跳转到 Spark History Server 的地址(须与 SPARK_HISTORY_OPTS 一致)
spark.yarn.historyServer.address      node01:18080
# 应用结束后仍可通过 RM UI 的 tracking URL 跳转
spark.yarn.historyServer.allowTracking true

# ================ Hadoop 集成 ================
spark.hadoop.fs.defaultFS             hdfs://hadoop-ha:8020
spark.hadoop.hadoop.security.authentication simple
# 未启用 Kerberos,因此不做授权校验
spark.hadoop.hadoop.security.authorization  false

# ================ 资源配置 ================
spark.executor.memory                 4g
spark.executor.cores                  2
spark.driver.memory                   1g
# Executor 堆外内存(容器总内存 = 4g + 1024m = 5g,需落在 YARN 允许区间内)
spark.executor.memoryOverhead         1024m
spark.yarn.queue                      default

# ================ Shuffle ================
spark.shuffle.service.enabled         true
spark.shuffle.service.port            7337
# 写入磁盘的缓冲区,默认 32k,适当调大可减少磁盘 IO
spark.shuffle.file.buffer             1m
spark.serializer                      org.apache.spark.serializer.KryoSerializer

# ================ 动态资源分配 ================
spark.dynamicAllocation.enabled       true
spark.dynamicAllocation.minExecutors  1
spark.dynamicAllocation.maxExecutors  20

# ================ SQL / 并行度 ================
spark.sql.shuffle.partitions          200
# 广播阈值,单位=字节,等价于 100MB(默认 10485760 即 10MB);-1 表示关闭广播
spark.sql.autoBroadcastJoinThreshold  104857600
spark.default.parallelism             200

# ================ 稳定性 ================
spark.network.timeout                 300s
spark.task.maxFailures                4
# FAIR 需要配合 fairscheduler.xml 才能使用自定义池;无多池需求时保持默认 FIFO 即可
spark.scheduler.mode                  FAIR
如需在 Spark UI 中直接查看 driver 日志(YARN 模式),可额外配置
spark.driver.log.dfsDir(需已开启日志聚集)并保持spark.ui.reverseProxy=true。
另外注意:spark.master与spark.submit.deployMode写在spark-defaults.conf中会成为全局默认值,spark-shell/pyspark(交互式,无法用 cluster 模式)将无法直接启动;交互调试时请显式指定--master local[*]。
3.4.3 修改 workers(可跳过)
编辑 /opt/spark/conf/workers(内容与 Hadoop 的 workers 一致,仅 Standalone 模式使用):
node01
node02
node03
3.5 配置环境变量与数据目录
三个节点均执行。
3.5.1 创建 Hadoop、Spark 数据目录并修改目录所属
mkdir -p /data/hadoop/{tmp,nn,dn,jn,logs}
mkdir -p /data/hadoop/logs/{nn,dn,jn,rm,nm,proxyserver,jobhistory}
mkdir -p /data/hadoop/logs/yarn/container-logs
mkdir -p /data/hadoop/yarn/local
mkdir -p /data/hadoop/pid
mkdir -p /data/hadoop/spark/{pid,work}
mkdir -p /data/hadoop/spark/logs/history-server

# 统一属主(ZooKeeper 目录在 3.2 中已处理)
chown -R hadoop:hadoop /data/hadoop
chown -R hadoop:hadoop /opt/hadoop-3.3.6
chown -R hadoop:hadoop /opt/spark-3.5.6-bin-hadoop3
3.5.2 配置环境变量
编辑 /etc/profile.d/hadoop_env.sh:
# Java
export JAVA_HOME=/opt/jdk
# ZooKeeper
export ZK_HOME=/opt/zookeeper
# Hadoop
export HADOOP_HOME=/opt/hadoop
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
# Spark
export SPARK_HOME=/opt/spark
# 统一 PATH
export PATH=$JAVA_HOME/bin:$ZK_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$SPARK_HOME/bin:$SPARK_HOME/sbin:$PATH
# 使环境变量生效
source /etc/profile.d/hadoop_env.sh
# 验证
echo $JAVA_HOME $HADOOP_HOME $SPARK_HOME
which hdfs yarn spark-submit zkServer.sh
3.6 启动 Hadoop HA 集群
以下操作均在 hadoop 用户下执行:
su - hadoop。
注意顺序:ZooKeeper → JournalNode → NameNode(format/bootstrapStandby) → ZKFC → HDFS → YARN → JobHistoryServer → Spark History Server。
3.6.1 切换 hadoop 用户
su - hadoop
3.6.2 三个节点启动 ZooKeeper
# node01、node02、node03 分别执行
zkServer.sh start

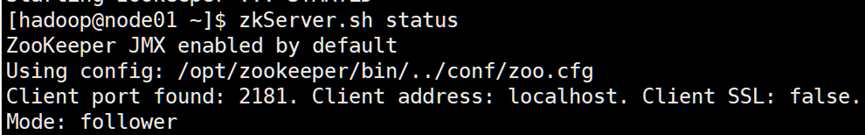
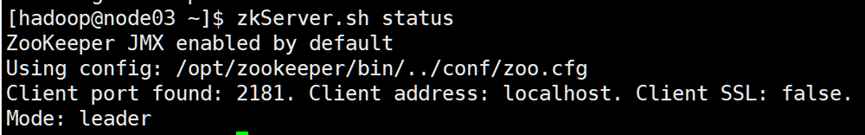
# 验证节点状态:应出现 1 个 leader、2 个 follower
zkServer.sh status
3.6.3 三个节点启动 JournalNode
# node01、node02、node03 分别执行
hdfs --daemon start journalnode
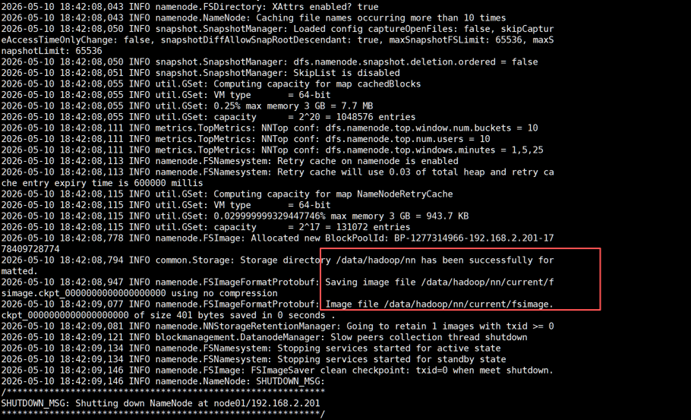
3.6.4 在 node01 初始化 NameNode 并启动
# node01 执行。注意:仅在集群首次部署时执行一次,重复执行会清空元数据!
hdfs namenode -format

# 启动 namenode01
hdfs --daemon start namenode
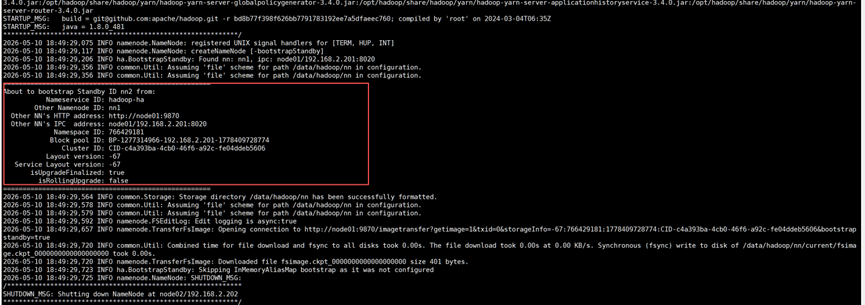
3.6.5 在 node02 同步元数据
# node02 执行。注意:仅首次执行,用于从 nn1 同步元数据并采用相同的 clusterID
hdfs namenode -bootstrapStandby
3.6.6 在 node01 初始化 ZKFC
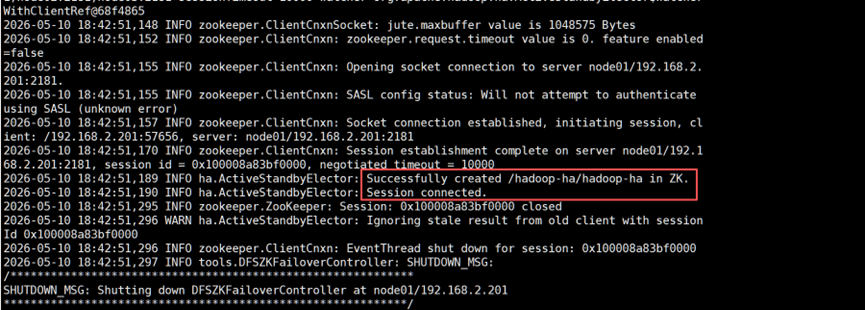
# node01 执行:在 ZooKeeper 中创建 HA 状态节点(须在 ZooKeeper 启动之后执行)
hdfs zkfc -formatZK
3.6.7 在 node01 启动 HDFS
# node01 执行:先停止手动启动的 namenode,再用脚本统一启动整个 HDFS
hdfs --daemon stop namenode
start-dfs.sh
start-dfs.sh会自动:在两个 NameNode 节点启动 NameNode 与 ZKFC、在三个 JournalNode 节点启动 JournalNode、在workers列出的节点启动 DataNode。
已在运行的 JournalNode 会提示"already running"并被跳过,属正常现象。
3.6.8 启动 YARN(HA 场景的重点)
不要在 node01 上执行 start-yarn.sh。start-yarn.sh 只会在执行脚本的本机启动一个 ResourceManager,无法根据 yarn.resourcemanager.ha.rm-ids 启动多个 RM。在 node01(不在 rm-ids 中)执行会导致本机 RM 启动失败或产生游离进程。
推荐方式:按节点分别启动。
# node02 执行(rm1)
yarn --daemon start resourcemanager

# node03 执行(rm2)
yarn --daemon start resourcemanager

# node01、node02、node03 分别执行
yarn --daemon start nodemanager
也可以用脚本 + 手动补齐(等效):
# node02 执行:启动本机 rm1,并在所有 workers 上启动 NodeManager
start-yarn.sh
# node03 执行:补齐 rm2
yarn --daemon start resourcemanager
3.6.9 在 node03 启动 JobHistoryServer
# 1) 创建工作历史目录(任一节点执行,需 HDFS 已启动)
hdfs dfs -mkdir -p /jobhistory/done
hdfs dfs -mkdir -p /jobhistory/done_intermediate

# 2) 设置权限:done 目录 755;临时目录必须是 1777(sticky),否则作业会报权限拒绝
hdfs dfs -chown -R hadoop:hadoop /jobhistory
hdfs dfs -chmod -R 755 /jobhistory/done
hdfs dfs -chmod -R 1777 /jobhistory/done_intermediate

# 3) 验证
hdfs dfs -ls -d /jobhistory /jobhistory/done /jobhistory/done_intermediate

# 4) node03 启动历史服务器
mapred --daemon start historyserver
3.6.10 在 node01 启动 Spark History Server
# 1) 打包 Spark 依赖并上传到 HDFS(需已安装 zip,见 2.1)
cd /opt/spark/jars
zip -r spark-libs.zip *.jar
hdfs dfs -mkdir -p /spark-jars
hdfs dfs -put -f spark-libs.zip /spark-jars/

# 2) 创建事件日志目录(与 spark.history.fs.logDirectory 一致)
hdfs dfs -mkdir -p /sparkhistory
hdfs dfs -chown hadoop:hadoop /sparkhistory
hdfs dfs -chmod 755 /sparkhistory

# 3) 验证归档文件存在(该路径必须与 spark.yarn.archive 完全一致)
hdfs dfs -ls /spark-jars/spark-libs.zip

# 4) node01 启动 History Server
start-history-server.sh
注意事项:
spark.yarn.archive指向的路径必须已存在,否则spark-submit会直接报Path does not exist。后续升级 Spark 或增删依赖 jar 后,需要重新打包上传。- 事件日志由提交作业的用户写入,因此
/sparkhistory的属主应是提交用户(此处为hadoop)。若存在多用户提交,可放宽为1777。
3.6.11 查看组件状态
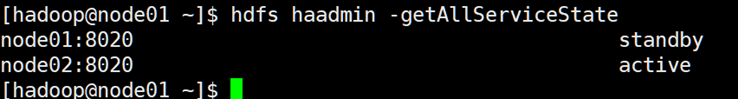
# 查看 NameNode 主备状态(应为一个 active、一个 standby)
hdfs haadmin -getAllServiceState

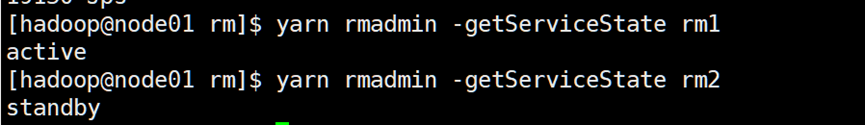
# 查看 ResourceManager 主备状态
yarn rmadmin -getAllServiceState
yarn rmadmin -getServiceState rm1
yarn rmadmin -getServiceState rm2
浏览器访问(本文统一使用主机名,需保证客户端能解析 node01~node03):
| 组件 | 地址 |
|---|---|
| NameNode(nn1,node01) | http://node01:9870 |
| NameNode(nn2,node02) | http://node02:9870 |
| ResourceManager(rm1,node02) | http://node02:18088/cluster |
| ResourceManager(rm2,node03) | http://node03:18088/cluster |
| MapReduce JobHistory | http://node03:19888/jobhistory |
| Spark History Server | http://node01:18080 |
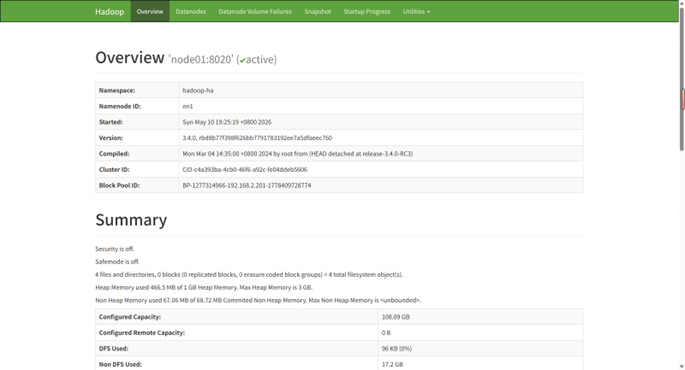
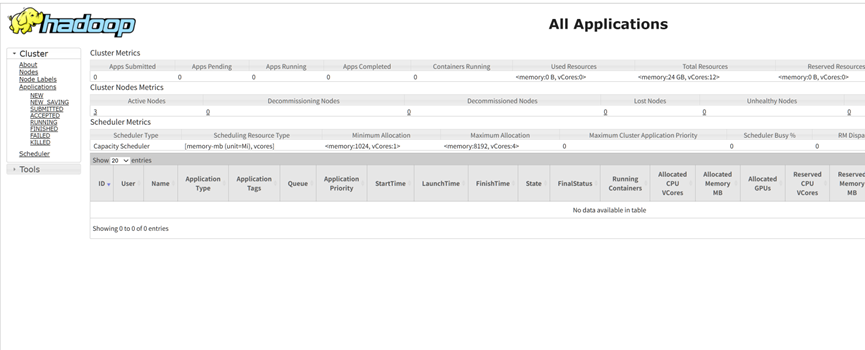
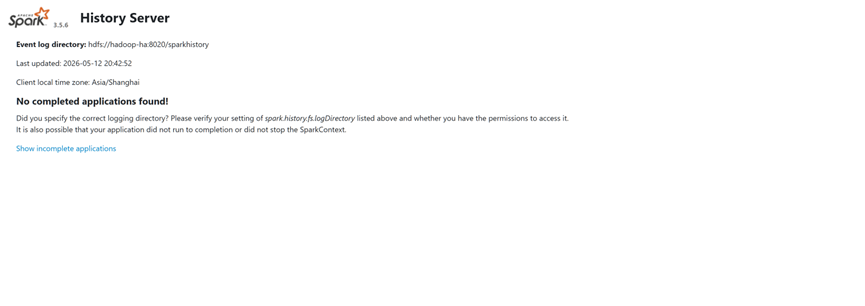
访问备用 ResourceManager 会被自动重定向到主节点,这是正常现象(主备模式的预期行为);备用 NameNode 页面则直接显示
standby状态,不会跳转。
3.7 配置开机自启
3.7.1 停止集群(按与启动相反的顺序)
# 1、停止 Spark History Server【node01】
stop-history-server.sh

# 2、停止 JobHistoryServer【node03】
mapred --daemon stop historyserver

# 3、停止 YARN【node01、node02、node03】
yarn --daemon stop nodemanager
yarn --daemon stop resourcemanager      # 仅 node02、node03

# 4、停止 HDFS【node01 执行脚本即可】
stop-dfs.sh

# 5、停止 ZooKeeper【node01、node02、node03】
zkServer.sh stop
3.7.2 配置 systemd 服务
按角色创建单元文件,节点角色表如下:
| 单元文件 | node01 | node02 | node03 |
|---|---|---|---|
zookeeper.service | ✅ | ✅ | ✅ |
journalnode.service | ✅ | ✅ | ✅ |
datanode.service | ✅ | ✅ | ✅ |
nodemanager.service | ✅ | ✅ | ✅ |
namenode.service | ✅ | ✅ | — |
zkfc.service | ✅ | ✅ | — |
resourcemanager.service | — | ✅ | ✅ |
jobhistoryserver.service | — | — | ✅ |
spark-historyserver.service | ✅ | — | — |
① zookeeper.service(三节点)
# vim /etc/systemd/system/zookeeper.service
[Unit]
Description=Apache ZooKeeper Server
Documentation=https://zookeeper.apache.org/
After=network-online.target
Wants=network-online.target

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
PIDFile=/data/hadoop/zookeeper/data/zookeeper_server.pid
Environment="ZOO_LOG_DIR=/data/hadoop/zookeeper/logs"
ExecStart=/opt/zookeeper/bin/zkServer.sh start
ExecStop=/opt/zookeeper/bin/zkServer.sh stop
ExecReload=/opt/zookeeper/bin/zkServer.sh restart
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
② journalnode.service(三节点)
# vim /etc/systemd/system/journalnode.service
[Unit]
Description=Apache Hadoop JournalNode Service
After=network-online.target zookeeper.service
Wants=network-online.target zookeeper.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-journalnode.pid
ExecStart=/opt/hadoop/bin/hdfs --daemon start journalnode
ExecStop=/opt/hadoop/bin/hdfs --daemon stop journalnode
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
③ namenode.service(node01、node02)
# vim /etc/systemd/system/namenode.service
[Unit]
Description=Apache Hadoop NameNode Service
After=network-online.target zookeeper.service journalnode.service
Wants=network-online.target zookeeper.service journalnode.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-namenode.pid
ExecStart=/opt/hadoop/bin/hdfs --daemon start namenode
ExecStop=/opt/hadoop/bin/hdfs --daemon stop namenode
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
④ zkfc.service(node01、node02)
# vim /etc/systemd/system/zkfc.service
[Unit]
Description=Apache Hadoop ZK Failover Controller Service
After=network-online.target zookeeper.service journalnode.service namenode.service
Wants=network-online.target zookeeper.service journalnode.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-zkfc.pid
ExecStart=/opt/hadoop/bin/hdfs --daemon start zkfc
ExecStop=/opt/hadoop/bin/hdfs --daemon stop zkfc
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑤ datanode.service(三节点)
# vim /etc/systemd/system/datanode.service
[Unit]
Description=Apache Hadoop DataNode Service
After=network-online.target journalnode.service
Wants=network-online.target journalnode.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-datanode.pid
ExecStart=/opt/hadoop/bin/hdfs --daemon start datanode
ExecStop=/opt/hadoop/bin/hdfs --daemon stop datanode
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑥ resourcemanager.service(node02、node03)
# vim /etc/systemd/system/resourcemanager.service
[Unit]
Description=Apache Hadoop ResourceManager Service
After=network-online.target zookeeper.service
Wants=network-online.target zookeeper.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-resourcemanager.pid
ExecStart=/opt/hadoop/bin/yarn --daemon start resourcemanager
ExecStop=/opt/hadoop/bin/yarn --daemon stop resourcemanager
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑦ nodemanager.service(三节点)
# vim /etc/systemd/system/nodemanager.service
[Unit]
Description=Apache Hadoop NodeManager Service
After=network-online.target resourcemanager.service
Wants=network-online.target resourcemanager.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-nodemanager.pid
ExecStart=/opt/hadoop/bin/yarn --daemon start nodemanager
ExecStop=/opt/hadoop/bin/yarn --daemon stop nodemanager
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑧ jobhistoryserver.service(node03)
# vim /etc/systemd/system/jobhistoryserver.service
[Unit]
Description=Apache Hadoop JobHistoryServer Service
After=network-online.target resourcemanager.service
Wants=network-online.target resourcemanager.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
WorkingDirectory=/opt/hadoop
PIDFile=/data/hadoop/pid/hadoop-hadoop-historyserver.pid
ExecStart=/opt/hadoop/bin/mapred --daemon start historyserver
ExecStop=/opt/hadoop/bin/mapred --daemon stop historyserver
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑨ spark-historyserver.service(node01)
# vim /etc/systemd/system/spark-historyserver.service
[Unit]
Description=Apache Spark History Server Service
After=network-online.target namenode.service zkfc.service
Wants=network-online.target namenode.service

[Service]
Type=forking
User=hadoop
Group=hadoop
Environment="JAVA_HOME=/opt/jdk"
Environment="SPARK_HOME=/opt/spark"
Environment="HADOOP_CONF_DIR=/opt/hadoop/etc/hadoop"
WorkingDirectory=/opt/spark
PIDFile=/data/hadoop/spark/pid/spark-hadoop-org.apache.spark.deploy.history.HistoryServer-1.pid
ExecStart=/opt/spark/sbin/start-history-server.sh
ExecStop=/opt/spark/sbin/stop-history-server.sh
Restart=on-failure
RestartSec=30
TimeoutStopSec=300

[Install]
WantedBy=multi-user.target
⑩ 重载并按角色启用
# 三个节点分别执行
systemctl daemon-reload

# node01
systemctl enable zookeeper journalnode datanode nodemanager namenode zkfc spark-historyserver

# node02
systemctl enable zookeeper journalnode datanode nodemanager namenode zkfc resourcemanager

# node03
systemctl enable zookeeper journalnode datanode nodemanager resourcemanager jobhistoryserver
⑪ 按顺序启动并验证
# 1、ZooKeeper【node01、node02、node03】
systemctl start zookeeper

# 2、JournalNode【node01、node02、node03】
systemctl start journalnode

# 3、NameNode【node01、node02】
systemctl start namenode

# 4、ZKFC【node01、node02】
systemctl start zkfc

# 5、DataNode【node01、node02、node03】
systemctl start datanode

# 6、ResourceManager【node02、node03】
systemctl start resourcemanager

# 7、NodeManager【node01、node02、node03】
systemctl start nodemanager

# 8、JobHistoryServer【node03】
systemctl start jobhistoryserver

# 9、Spark History Server【node01】
systemctl start spark-historyserver

# 验证:所有单元应为 active (running),且已开机自启(enabled)
systemctl --no-pager --type=service --state=running | grep -E 'zookeeper|hadoop|spark|namenode|datanode|journalnode|zkfc|manager|historyserver'
3.8 验证集群高可用性
3.8.1 验证 HDFS 高可用
假设 node01 的 NameNode 为 active、node02 为 standby:
# 1) 确认当前状态
hdfs haadmin -getAllServiceState

# 2) 停止 node01 的 NameNode(模拟故障)
#    node01 执行
systemctl stop namenode

# 3) 观察 node02 是否在数秒内自动转为 active
hdfs haadmin -getAllServiceState

# 4) 浏览器访问,确认页面状态已由 standby 变为 active
#    http://node02:9870

# 5) 恢复 node01(会以 standby 身份重新加入)
#    node01 执行
systemctl start namenode
也可以在不停服务的情况下手工触发切换:
# 将 nn1 切为 standby、nn2 切为 active
hdfs haadmin -failover --forcefence --forceactive nn1 nn2
3.8.2 验证 YARN 高可用
假设 node02 的 ResourceManager 为 active、node03 为 standby:
# 1) 确认当前状态
yarn rmadmin -getAllServiceState

# 2) 停止 node02 的 ResourceManager(模拟故障)
#    node02 执行
systemctl stop resourcemanager

# 3) 观察 node03 是否自动转为 active
yarn rmadmin -getAllServiceState

# 4) 浏览器访问,确认不再重定向
#    http://node03:18088

# 5) 恢复 node02
#    node02 执行
systemctl start resourcemanager
# 不停服务的情况下手工触发切换
yarn rmadmin -failover rm1 rm2
判断要点:如果页面能直接打开且状态为 active,说明切换成功;如果被重定向到
node02:18088,说明仍处于 standby。
注意 Spark on YARN 本身没有"主备"概念,Spark 的高可用依赖 YARN(RM HA)与 HDFS(NN HA),另外 Spark History Server 为单点(本文部署在 node01),如需可用可按相同方式在其它节点部署并在前端做负载/代理。
3.9 测试 Spark 任务
统一使用 hadoop 用户提交(与 HDFS 目录属主、YARN 队列权限保持一致):
su - hadoop
3.9.1 使用 Spark 自带示例程序(建议先跑通)
spark-submit \
  --class org.apache.spark.examples.SparkPi \
  --master yarn \
  --deploy-mode cluster \
  --driver-memory 1g \
  --executor-memory 1g \
  --executor-cores 1 \
  $SPARK_HOME/examples/jars/spark-examples_2.12-3.5.6.jar \
  100
3.9.2 使用业务 jar 提交
spark-submit \
  --class <业务 jar 中的真实主类> \
  --master yarn \
  --deploy-mode cluster \
  --driver-memory 1g \
  --executor-memory 1g \
  --executor-cores 1 \
  hdfs://hadoop-ha:8020/etl/qdata-etl-3.8.8.jar \
  <业务参数>
3.9.3 查看运行结果与日志
# 查看作业列表与状态
yarn application -list
yarn application -list -appStates ALL

# 集群模式下 driver 的标准输出在容器日志里,需要聚合日志查看结果
yarn logs -applicationId <application_xxx_0001>
yarn logs -applicationId <application_xxx_0001> -log_files stdout

# 需要时终止作业
yarn application -kill <application_xxx_0001>
验证入口:
| 位置 | 说明 |
|---|---|
| http://node02:18088 或 http://node03:18088 | YARN 应用列表、资源使用、容器日志(需开启日志聚集) |
| http://node03:19888/jobhistory | MapReduce 历史作业 |
| http://node01:18080 | Spark 应用事件日志与 SQL/Stage 详情 |
3.10 常见问题排查
| 现象 | 原因与处理 |
|---|---|
hdfs namenode -bootstrapStandby 报 Cannot lock storage / JournalNode ... not enough | JournalNode 未全部启动。先执行 hdfs --daemon start journalnode(三节点),再重试 |
hdfs zkfc -formatZK 报连接 ZooKeeper 失败 | ZooKeeper 未启动或 ha.zookeeper.quorum 配置错误;先确认 zkServer.sh status 正常 |
| ZooKeeper 启动后无法选主 | 检查各节点 dataDir/myid 是否存在且与 zoo.cfg 的 server.N 一一对应;检查 2888/3888 端口 |
start-yarn.sh 后只有一台 RM / node01 上出现 RM 进程 | start-yarn.sh 只在执行节点启动 RM。按 3.6.8 在 node02、node03 分别启动 |
Spark 容器被 YARN 杀掉:running beyond virtual memory limits | 设置 yarn.nodemanager.vmem-check-enabled=false(本文已配置),或调大 yarn.nodemanager.vmem-pmem-ratio |
spark-submit 报 Path does not exist: hdfs://hadoop-ha/spark-jars/spark-libs.zip | 未执行 3.6.10 的打包上传步骤,或路径与 spark.yarn.archive 不一致 |
ClassNotFoundException(自定义主类) | --class 与 jar 不匹配,或该 jar 未被打入容器依赖;检查 --jars/--files |
作业报 Permission denied: user=xxx, access=WRITE, inode="/jobhistory/done_intermediate" | 执行 hdfs dfs -chmod -R 1777 /jobhistory/done_intermediate |
| Spark History Server 能开但看不到应用 | spark.eventLog.dir 与 spark.history.fs.logDirectory 不一致,或 /sparkhistory 无写权限 |
| RM UI 上点击 ApplicationHistory 无法跳转到 Spark UI | spark.yarn.historyServer.address 与实际 HS 地址不一致(须为 node01:18080) |
su hadoop 后找不到 hdfs/spark-submit | 必须使用 su - hadoop(登录式 shell)才会加载 /etc/profile.d;或手动 source /etc/profile.d/hadoop_env.sh |
| systemd 启动守护进程失败、提示找不到 Java | 单元中 JAVA_HOME 与实际 JDK 路径不一致;同时确认 /opt/jdk 软链接存在 |
| 集群重启后 HDFS 处于 safemode | 等待 DataNode 上报;用 hdfs dfsadmin -safemode get 查看,必要时 -safemode leave |
附录:集群巡检命令清单
# 1) 进程与单元状态
jps -l                                  # 各节点守护进程
systemctl --no-pager --type=service --state=running | grep -E 'hadoop|zookeeper|spark'

# 2) ZooKeeper
zkServer.sh status                      # 1 leader + 2 follower

# 3) HDFS
hdfs haadmin -getAllServiceState        # nn1/nn2 主备
hdfs dfsadmin -report                   # DataNode 数量、容量
hdfs dfsadmin -safemode get             # 是否为安全模式

# 4) YARN
yarn rmadmin -getAllServiceState        # rm1/rm2 主备
yarn node -list -all                    # NodeManager 列表与资源
yarn application -list -appStates ALL   # 应用列表

# 5) Spark
yarn logs -applicationId <appId>        # 作业日志
curl -s http://node01:18080 | head      # History Server 存活检查

# 6) 时间同步
chronyc sources -v

# 7) 磁盘与日志(重点关注 nn/dn/container-logs 增长)
df -h /data
du -sh /data/hadoop/logs/* | sort -h
评论